Qwen3.8 27B — 4bit/8bit/Flash Next 비교, 그리고 DFlash2는 정말 lossless인가
Qwen3.8 27B를 4bit/8bit/Flash Next로 재보고, DFlash2 speculative decoding까지 붙여봤습니다. 속도는 2~3배 빨라졌지만 공식 주장과 달리 M5에서는 출력이 원본과 갈라졌습니다.
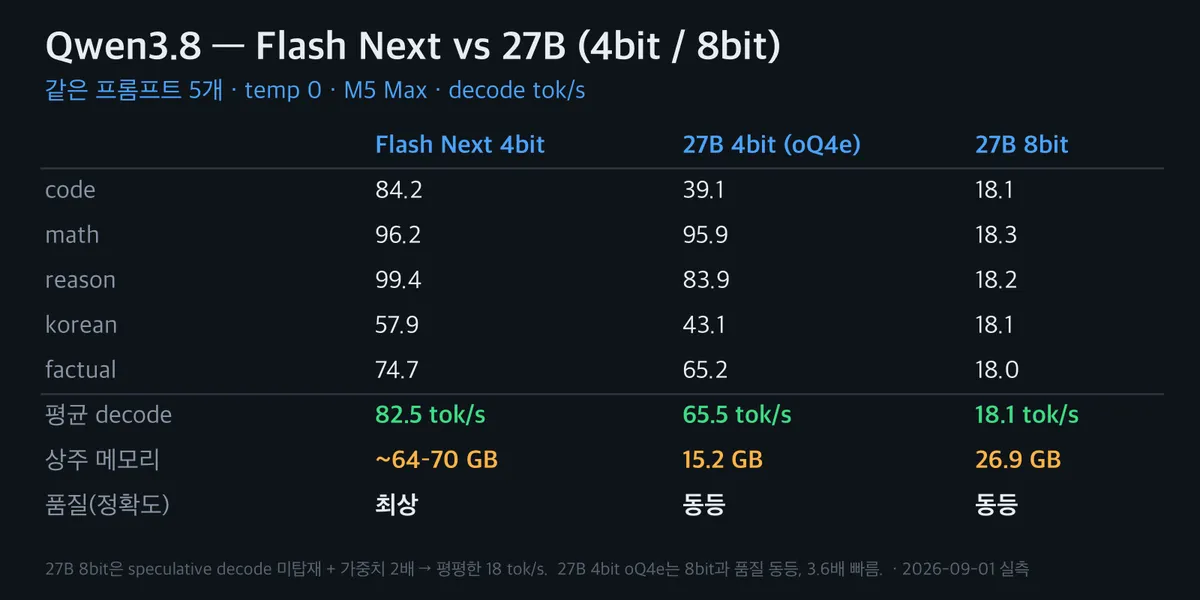
로컬로 27B를 쓸 때 4bit이 낫냐 8bit이 낫냐, 늘 감으로만 골랐습니다. 8bit이 정확도가 높으니 여유되면 8bit 쓰는 게 맞겠거니 했고요. 이번에 같은 맥에서 직접 재봤는데, 생각과 달랐습니다.
내친김에 지난 글에서 다룬 Flash Next(125B MoE)까지 같은 프롬프트로 붙여서 셋을 비교했습니다.
뭘 비교했나
전부 M5 Max, 같은 프롬프트 5개(코드, 수학, 논리 퍼즐, 한국어 설명, 지식 질문), temp 0으로 고정했습니다.
- 27B 4bit — oQ4e 양자화. 대부분 4bit인데 민감한 레이어만 5bit로 올린 혼합 방식입니다. 가중치 16GB.
- 27B 8bit — 순수 8bit. 가중치 28GB.
- Flash Next 4bit — 125B지만 MoE라 한 번에 6B만 씁니다.
메모리가 문제였습니다. Flash Next가 70GB를 쓰는 채로 8bit(28GB)까지 올리면 예전에 겪은 프리즈 조건에 걸립니다. 그래서 셋을 동시에 안 올리고, 하나씩 단독으로 재서 경합을 없앴습니다.
속도
decode(토큰 생성) 속도입니다. 단위는 tok/s.
| 프롬프트 | Flash Next 4bit | 27B 4bit | 27B 8bit |
|---|---|---|---|
| code | 84.2 | 39.1 | 18.1 |
| math | 96.2 | 95.9 | 18.3 |
| reason | 99.4 | 83.9 | 18.2 |
| korean | 57.9 | 43.1 | 18.1 |
| factual | 74.7 | 65.2 | 18.0 |
| 평균 | 82.5 | 65.5 | 18.1 |
8bit이 제일 느립니다. 그것도 3.6배나. 예상보다 훨씬 큰 차이라 처음엔 메모리 페이징을 의심했는데, 8bit만 단독으로 올려서(free 15GB 여유) 다시 재도 똑같이 18이 나왔습니다. 진짜 속도가 맞습니다.
이유는 두 가지로 봅니다. 하나는 8bit이 4bit보다 가중치가 두 배라, decode할 때 읽어야 할 양 자체가 두 배입니다. decode는 메모리 대역폭 싸움이라 이게 그대로 속도로 옵니다. 다른 하나는 4bit(oQ4e) 빌드는 speculative decode가 붙는데 8bit 빌드엔 없다는 겁니다. 4bit 쪽 속도가 프롬프트마다 39~96으로 출렁이는 게 그 증거입니다. 프롬프트를 많이 되받는 수학·논리 문제에서 확 빨라지거든요. 8bit은 그게 없어서 뭘 시켜도 평평하게 18입니다.
품질
속도가 저러면 8bit을 쓸 이유는 정확도밖에 없습니다. 그래서 같은 답들을 하나씩 봤습니다.
결론부터 말하면 4bit과 8bit이 사실상 똑같았습니다. 수학 문제(45분에 60km → 80km/h) 둘 다 맞고, 논리 퍼즐(빨간 집 위치)도 둘 다 정확히 풀고, 피보나치 코드도 둘 다 제대로 나왔습니다. TCP/UDP 차이도 둘 다 정확했고요.
한국어 ‘양자화’ 설명만 조금 달랐는데, 오히려 8bit 쪽이 “돈은 1원 단위로만 있고 0.5원짜리는 없다” 같은 비유를 써서 약간 나았습니다. 하지만 4bit도 틀린 건 아니고, 이 정도는 그냥 seed 차이 수준입니다.
정리하면 oQ4e 4bit의 “민감한 레이어만 5bit로 남기는” 방식이 제 역할을 합니다. 대부분을 4bit으로 눌러 빠르고 가벼우면서, 품질이 중요한 부분은 정밀도를 지켜서 8bit이랑 차이가 안 납니다.
Flash Next는 어떤가
125B짜리가 27B보다 빠릅니다. MoE라 실제로는 6B만 돌리는 데다 speculative decode까지 있어서, 평균 82.5 tok/s로 셋 중 제일 빨랐습니다.
품질도 좋았습니다. 특히 한국어 양자화 설명에서 유일하게 “저장 공간을 줄이고 처리를 빠르게 한다”는 실제 용도까지 짚었습니다. 나머지 둘은 물리 정의만 설명했고요. 큰 차이는 아니지만 알고 답하는 느낌은 Flash Next가 제일 나았습니다.
대신 메모리를 6470GB 먹습니다. 27B 4bit이 15GB인 걸 생각하면 45배입니다.
+) DFlash2 speculative decoding도 붙여봤다
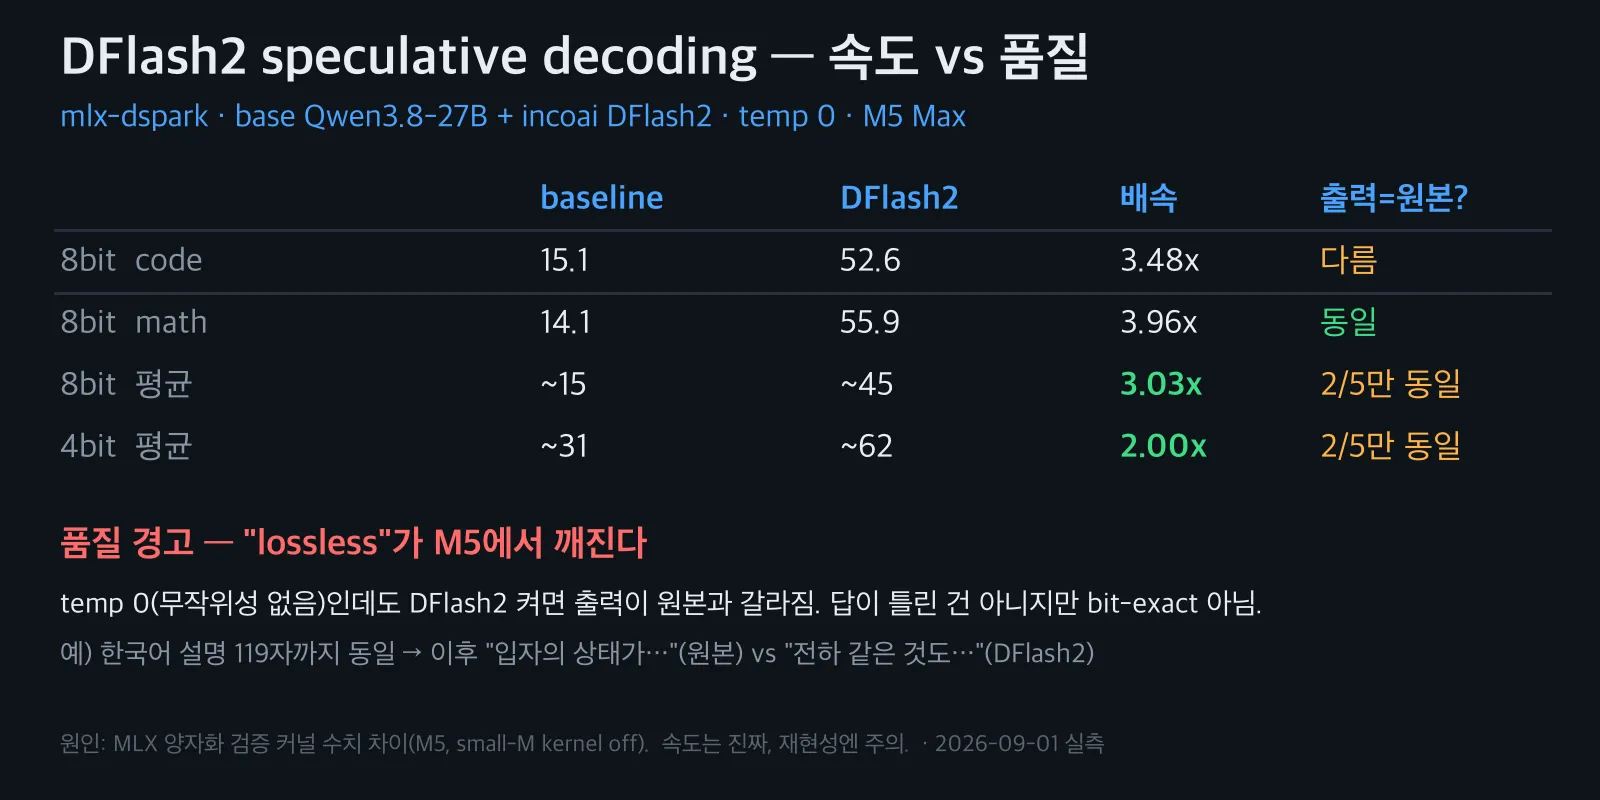
8bit이 느린 게 speculative decode가 없어서라는 걸 알고 나니, 아예 제대로 된 speculative 방식인 DFlash2를 붙이면 어떨지 궁금했습니다. z-lab이 만든 block-diffusion drafter인데, 공식적으로 “lossless — 원본이랑 글자 하나 안 틀리고 3.6배 빠르다”고 합니다.
함정 1 — mlx-serve로는 안 돌아간다
먼저 삽질을 좀 했습니다. mlx-serve의 --drafter에 DFlash2를 넣으면 로드는 되는데 실제 디코딩에선 안 씁니다. 속도가 하나도 안 올라서 한참 헤맸습니다. DFlash2를 MLX에서 돌리는 건 별도 패키지 mlx-dspark였습니다. 그리고 drafter도 base 모델(mlx-community/Qwen3.8-27B)에 맞춰진 incoai/Qwen3.8-27B-DFlash2를 써야 합니다.
속도는 진짜 빨라진다
base 모델 + incoai drafter로 제대로 붙이니 속도는 확실했습니다. 전부 temp 0.
| baseline | DFlash2 | 배속 | |
|---|---|---|---|
| 8bit 평균 | ~15 tok/s | ~45 tok/s | 3.03x |
| 4bit 평균 | ~31 tok/s | ~62 tok/s | 2.00x |
공식 수치(8bit 3.63×, 4bit 2.30×)에 근접합니다. 조금 낮은 건 M5 때문인데, mlx-dspark가 M5에서 검증 커널 하나(small-M)를 하드웨어 이슈로 꺼버립니다. 로그에 계속 경고가 떴습니다.
그런데 “lossless”가 안 지켜진다
여기가 진짜입니다. DFlash2의 셀링포인트는 “가속해도 원본과 똑같은 답”인데, 재보니 아니었습니다.
temp 0이면 무작위성이 없어서 몇 번을 돌리든 글자 하나까지 같아야 합니다. 실제로 baseline은 두 번 돌려도 완전히 같았습니다. 그런데 DFlash2를 켜고 끄면 답이 중간부터 갈라집니다. 8bit도 4bit도 5개 중 2개만 원본과 일치했습니다.
한국어 설명이 대표적이었습니다.
[119자까지 완전히 동일]
"양자화란 ... 물리에서는 에너지나 "

DFlash2 끔:  ...입자의 상태가 이런 최소 단위로만 나타나는 현상을 양자화라고 부릅니다.
DFlash2 켬:  ...전하 같은 것도 이런 최소 단위로만 움직인다고 봅니다.
원리상 이러면 안 됩니다. DFlash2는 drafter가 미리 찍은 토큰을 본 모델이 검증해서 채택/기각하는 구조라, 검증만 정확하면 출력은 원본과 같아야 합니다. 그런데 검증할 때랑 그냥 한 토큰씩 뽑을 때 계산 경로가 달라서 미세한 수치 차이가 생기고, 그게 어느 순간 다음 단어 선택을 뒤집습니다. MLX 양자화 커널이 M5에서 그렇습니다.
오해는 없어야겠습니다. 답이 틀린 건 아닙니다. 위 한국어도 둘 다 맞고, 수학·논리도 정답이었습니다. “틀렸다”가 아니라 “원본과 다르다”입니다. 문제가 되는 건 재현성입니다. “temp 0이면 항상 같은 답”을 전제로 하는 테스트나 캐싱에서는 답이 흔들립니다. 그리고 무엇보다 “lossless라서 마음 놓고 켠다”는 공식 설명이 이 하드웨어에선 안 맞습니다.
4bit이면 그냥 oQ4e MTP가 낫다
한 가지 더. 위에서 쓴 oQ4e 4bit은 자체 MTP 헤드가 있어서 65~75 tok/s가 나왔습니다. DFlash2를 붙인 base 4bit(62 tok/s대)보다 빠르고, 별도 drafter도 안 받아도 됩니다. 4bit 실사용이면 oQ4e + 내장 MTP가 가장 깔끔했습니다.
정리하면 DFlash2는 속도는 광고대로였지만, 이 M5에서 “lossless”는 아니었습니다. 빠른 초안이 필요하면 좋고, 원본과 똑같은 출력이 보장돼야 하면 아직은 조심해야 합니다.
그래서 뭘 쓰나
| 평균 decode | 상주 메모리 | 품질 | |
|---|---|---|---|
| Flash Next 4bit | 82.5 tok/s | 64–70 GB | 최상 |
| 27B 4bit (oQ4e) | 65.5 tok/s | 15 GB | 동등 |
| 27B 8bit | 18.1 tok/s | 27 GB | 동등 |
- 27B 8bit은 쓸 이유를 못 찾았습니다. 4bit이랑 품질이 같은데 3.6배 느리고 메모리도 더 씁니다. 적어도 지금 이 빌드로는요. 8bit에 speculative decode가 붙은 빌드가 있으면 얘기가 달라질 수 있는데, 그건 없었습니다.
- 메모리가 빠듯하면 27B 4bit(oQ4e). 15GB로 이 정도 품질에 65 tok/s면 가성비가 좋습니다.
- 메모리가 넉넉하면 Flash Next. 제일 빠르고 제일 똑똑한데, 대신 70GB를 통째로 내줘야 합니다.
8bit이 무조건 낫다는 건 편견이었습니다. 양자화를 어떻게 하느냐(어느 레이어를 지키느냐)랑 speculative decode가 붙느냐가, 그냥 bit 수보다 훨씬 크게 작용했습니다.
(2026-09-01 실측. temp 0, 프롬프트 5개짜리 작은 표본이라 경향으로만 보시면 됩니다.)