M5 Max에서 Qwen3.8 Flash Next 돌려보기, 그리고 prefill과의 싸움
125B MoE 모델을 맥 한 대에 올려서 에이전트 백엔드로 썼습니다. 느린 게 모델 탓인 줄 알았는데, 하루 파보니 진짜 범인은 prefill이었습니다. 캐시와 옵션 몇 개로 잡은 기록입니다.
맥 한 대로 로컬 LLM을 제대로 써보고 싶었습니다. 128GB M5 Max에 Qwen3.8 Flash Next 4bit를 올리고, 에이전트 백엔드로 붙여서 하루 종일 실제 작업을 시켰습니다.
처음엔 답답했습니다. 대화가 길어지면 한 턴에 몇 분씩 걸렸거든요. 모델이 원래 이 정도인가 싶었는데, 로그를 파보니 아니었습니다. 범인은 prefill이었습니다.
뭘 올렸나
- 모델: Qwen3.8 Flash Next, 총 125B에 활성 6B짜리 MoE, 4bit. GDN + full attention 섞인 48층에 MTP 헤드까지 들어있습니다. 상주 메모리는 대략 64~70GB.
- 서버: mlx-serve 26.8.11. Apple Silicon 네이티브라 Python이 필요 없고, OpenAI/Anthropic API를 그대로 받습니다.
- 하드웨어: M5 Max, 128GB. 컨텍스트는 131,072.
decode는 생각보다 잘 나왔다
먼저 토큰 생성(decode) 속도부터.
| 컨텍스트 | decode |
|---|---|
| 0~20K | 75~91 tok/s |
| 40~60K | 68 tok/s |
| 60~80K | 58 tok/s |
| 80~100K | 57 tok/s |
decode는 메모리 대역폭 싸움입니다. 토큰 하나 뽑을 때마다 활성 가중치를 훑어야 하는데, 이건 통합 메모리 대역폭이 넉넉한 맥이 의외로 잘합니다. MoE라 125B 중 6B만 건드리는 것도 크고요. 컨텍스트가 길어질수록 느려지는 건 어쩔 수 없지만, 이 정도면 쓸 만합니다.
문제는 여기가 아니었습니다.
진짜 느린 건 prefill이었다
prefill은 프롬프트 전체를 한 번에 읽어서 KV 캐시를 채우는 단계입니다. decode랑 다르게 연산량 자체가 병목이라, 이게 맥의 약점입니다.
클라우드 GPU는 10만 토큰을 515초에 끝냅니다. 같은 걸 이 맥은 처음 계산할 때 34분 걸렸습니다. 처리량이 130~500 tok/s밖에 안 나오니까요.
그래서 방향을 바꿨습니다. prefill을 빠르게 만들 방법은 없습니다. 대신 두 번 안 하게 만들면 됩니다. 하루 종일 한 일이 결국 이거였습니다.
캐시부터 살렸다
에이전트는 매 턴 프롬프트 앞부분(시스템 프롬프트 + 툴 정의)이 똑같고 뒤만 늘어납니다. mlx-serve가 이 앞부분의 KV를 캐시(RAM + SSD)에 들고 있다가 재사용하면, 다음 턴은 새로 늘어난 부분만 계산하면 됩니다.
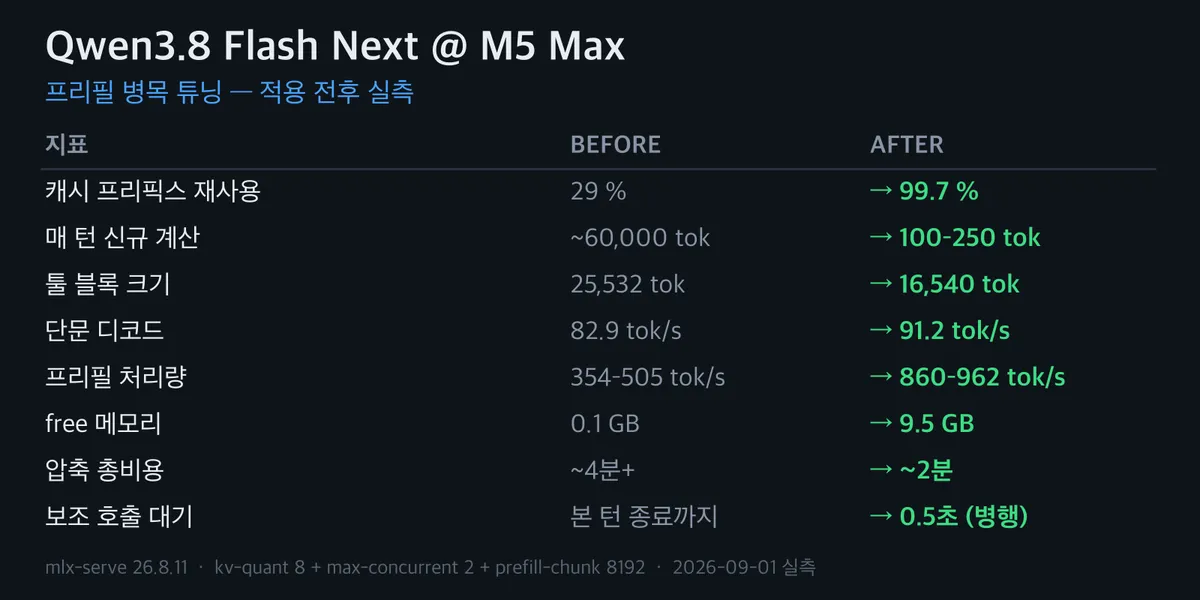
그런데 조건이 하나 있습니다. 앞부분이 1바이트라도 바뀌면 그 뒤는 전부 다시 계산합니다. 제 경우엔 툴 정의가 턴마다 미세하게 바뀌는 버그가 있었고, 그것 때문에 84K 중 24K(29%)만 재사용되고 나머지 6만 토큰을 매번 새로 계산하고 있었습니다.
원인을 잡고 나니 이렇게 바뀌었습니다.
캐시 재사용률    29%  →  99.7%
턴당 새로 계산    6만 토큰  →  100~250 토큰
같은 자리에서 4분씩 걸리던 게 몇백 토큰만 계산하면 되는 걸로 바뀐 겁니다.
옵션 하나 짚자면 --prefix-cache-entries는 1로 두지 마세요. 1이면 작은 요청 하나가 들어와도 본 대화를 캐시에서 밀어냅니다. 2 이상이면 둘 다 들고 있습니다.
툴 목록도 줄였다
툴 정의는 매 요청에 통째로 실립니다. 5주치 로그를 봤더니 등록만 해두고 한 번도 안 쓴 툴이 수두룩했습니다. 안 쓰는 걸 꺼버렸습니다.
툴 정의 25,532 토큰 → 16,540 토큰앞부분이 줄면 프롬프트가 그만큼 더 길어져야 압축이 걸리니, 압축 횟수도 같이 줄어듭니다.
서버 옵션 세 개
mlx-serve 옵션을 손봤습니다.
--kv-quant 8— KV 캐시를 8bit로 저장합니다. decode할 때 읽는 양이 절반이라 긴 컨텍스트가 빨라지고, 캐시가 반으로 줄어서 메모리도 풀립니다.--max-concurrent 2— 요청을 동시에 처리합니다. 에이전트가 중간에 던지는 요약/vision 같은 잔요청이 본 작업 뒤에 줄 서지 않습니다.--prefill-chunk 8192— MoE는 prefill 청크 경계마다 전문가 가중치를 다시 읽습니다. 청크를 키우면 그 횟수가 줄어듭니다.
켜고 나서:
단문 decode     82.9   →  91.2 tok/s
free 메모리      0.1GB  →  9.5GB
압축 총 시간     4분+   →  2분
잔요청 대기      본 턴 끝날 때까지  →  0.5초
prefill 처리량   354~505  →  860~962 tok/s
대화 요약(압축)은 요약 자체보다 그 뒤 재계산이 더 비쌉니다. prefill 처리량이 두 배가 되면서 이것도 반으로 줄었습니다.
두 번 멈췄다 (wedge)
밤새 돌리다가 서버가 두 번 멈췄습니다. 상태는 ready인데 아무 요청도 처리를 못 하는 상태였습니다. 로그엔 <- 0+0 tokens만 찍히고 CPU는 거의 0. 두 번 다 캐시가 15GB 근처까지 부었을 때였습니다.
처음엔 메모리 상한(--prefix-cache-mem)을 낮추면 될 줄 알았는데 소용없었습니다. 지금 쓰고 있는 항목 하나가 상한보다 크면 버릴 수가 없으니까요. 결국 --ctx-size를 절반으로 줄여서 캐시 항목 자체가 안 커지게 막았습니다. 이게 먹혔습니다.
벤치는 아직 돌리는 중
속도랑 별개로, 이 모델이 에이전트 작업을 실제로 해내는지 Terminal-Bench 2.1(89개)로 재고 있습니다. 아직 다 못 돌렸고 중간 결과만 있습니다.
- 파일럿 5개: 5개 다 통과
- 밤샘 부분 실행 22개: 13통과 / 9실패, 통과율 59%
89개 중 4분의 1 정도라 최종 점수는 아닙니다. 그래도 눈에 띈 패턴이 하나 있습니다.
통과한 것 평균  8.3분
실패한 것 평균  27.4분
빨리 푸는 건 통과하고, 오래 붙잡고 있으면 대체로 실패합니다. 문제를 파악하면 금방 끝내고, 못 하면 계속 헤매다 시간만 씁니다. 실패는 build/compile이나 암호·수치 알고리즘 쪽에 몰렸습니다. 전체 89개 결과는 다 돌리고 따로 정리하겠습니다.
공짜는 아니다
여기까지 “prefill 두 번 안 하기”로 정리했는데, 당연히 대가가 있습니다. 이걸 적어둬야 나중에 왜 이렇게 했는지 기억할 것 같습니다.
메모리를 대신 씁니다. 재사용하려면 KV를 어딘가 들고 있어야 하니까요. free 메모리가 76GB에서 0.1GB까지 떨어졌고, 대화 하나가 캐시로 12~15GB를 먹었습니다. 연산 부담을 메모리 부담으로 옮긴 셈이라, 캐시를 키울수록 빨라지지만 위의 wedge에 가까워집니다.
프롬프트 앞부분을 못 건드립니다. 캐시가 앞부분 일치에 걸려 있으니, 시스템 프롬프트에 시계 하나 넣는 것도, 툴을 중간에 바꾸는 것도 캐시를 날립니다. 특히 대화 압축이 그렇습니다. 요약하면 뒷부분이 다시 쓰이면서 캐시가 통째로 무효가 됩니다. 빠르게 하려면 앞을 고정해야 하는데, 그만큼 유연성은 포기하는 겁니다.
새 작업엔 안 통합니다. 캐시는 같은 앞부분이 반복될 때만 먹습니다. 첫 턴이나 처음 보는 긴 프롬프트는 그냥 다 계산합니다. 대화나 에이전트 루프에서만 이득이고, 일회성 긴 작업은 혜택이 없습니다.
kv-quant는 손실 압축입니다. 8bit는 체감이 거의 없지만, 어쨌든 KV를 다시 양자화하는 거라 수치나 암호처럼 정밀한 작업에선 결과가 틀어질 수 있습니다. 이상하면 --kv-quant off부터 해봐야 합니다.
| 얻은 것 | 낸 것 |
|---|---|
| prefill 안 함 | 메모리 압박, wedge 위험 |
| 턴당 몇백 토큰만 계산 | 앞부분 고정, 유연성 하락 |
| 캐시 절반 | kv-quant 손실 |
| 반복 대화 빠름 | 새 작업엔 무효 |
정리
결국 지금 이렇게 돌립니다.
mlx-serve serve --host 127.0.0.1 --port 11234 --mtp \
  --ctx-size 131072 --prefill-chunk 8192 \
  --kv-quant 8 --max-concurrent 2 \
  --prefix-cache-entries 2 --prefix-cache-mem 8GB --prefix-cache-disk 60GB
--host 127.0.0.1은 꼭 붙이세요. 기본이 0.0.0.0이라 안 그러면 로컬 네트워크에 열립니다.
맥에서 로컬 LLM을 쓸 만하게 만드는 건 모델보다 prefill을 어떻게 피하느냐였습니다. 효과 순서로는 캐시 재사용(29→99.7%)이 제일 크고, 그다음 프롬프트 줄이기, kv-quant 순이었습니다. decode는 원래 맥이 잘하니 손댈 게 없었고요. 다만 압축이 걸리거나 툴을 바꾸거나 새 긴 프롬프트가 들어오면 그때는 prefill 값을 고스란히 다시 냅니다.
(2026-09-01 기준. 숫자는 상황 따라 달라질 수 있습니다.)