Qwen3.8 Flash Next로 Terminal-Bench 밤새 돌린 기록
M5 Max에 올린 로컬 LLM이 실제 터미널 작업을 얼마나 해내는지 Terminal-Bench로 밤새 재봤습니다. 통과율보다 서버가 네 번 멈췄다가 스스로 살아난 게 더 인상적이었습니다.
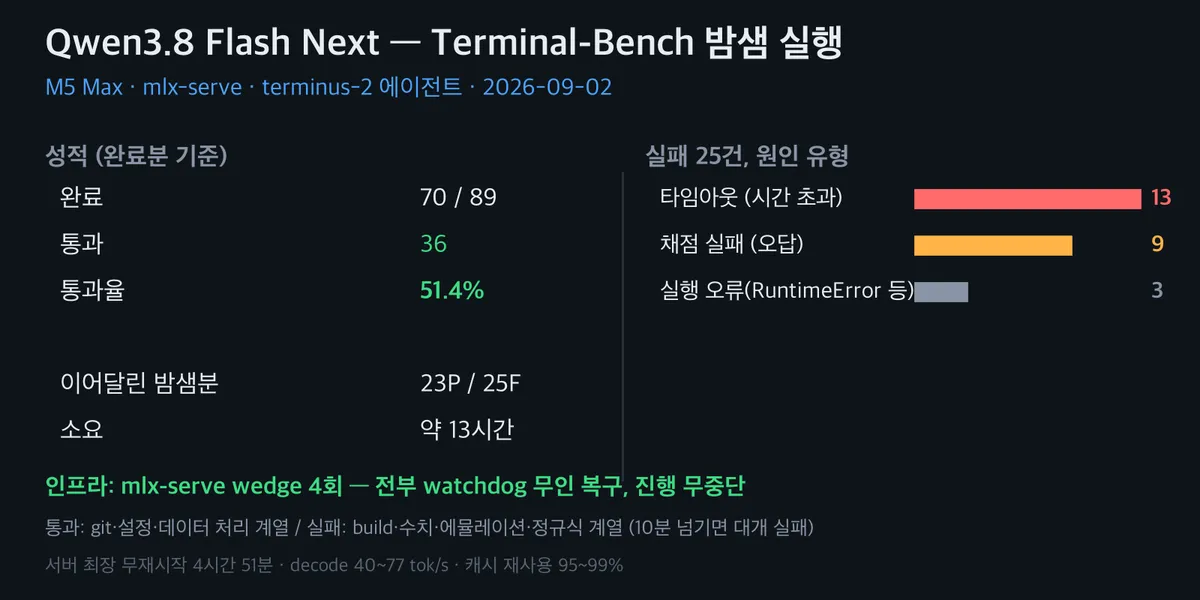
지난 글에서 Qwen3.8 Flash Next를 M5 Max에 올리고 속도를 잡는 얘기를 했습니다. 그런데 속도가 빠른 것과 실제 일을 잘하는 건 다른 문제라, 이 로컬 모델이 터미널 작업을 얼마나 해내는지 재보고 싶었습니다. Terminal-Bench로 밤새 돌렸습니다.
Terminal-Bench가 뭐냐
에이전트한테 실제 터미널 환경(도커 컨테이너)을 하나 주고, “이거 고쳐라 / 만들어라” 같은 과제를 시킨 뒤 검증 스크립트로 통과 여부를 채점하는 벤치입니다. git 저장소 복구, 서버 설정, 컴파일러 빌드, 알고리즘 구현 같은 게 89개 들어있습니다. 저는 terminus-2 에이전트에 이 로컬 모델을 백엔드로 붙여서 돌렸습니다.
결과부터
완료 70/89 · 통과 36 · 통과율 51.4%밤새 돌려서 89개 중 70개까지 채점했고 절반쯤 통과했습니다. 어려운 태스크가 시간을 오래 먹어서 완주는 못 했습니다.
솔직히 통과율 자체는 큰 의미를 두기 어렵습니다. 표본이 89개 전부도 아니고, 로컬 4bit 모델한테 클라우드 프론티어 모델용 벤치를 시킨 거니까요. 그것보다 눈에 띈 패턴 두 개가 더 흥미로웠습니다.
통과와 실패는 종류가 갈렸다
통과한 것들: git 저장소 복구, 웹서버 설정, self-signed 인증서 발급, 데이터 병합, 로그 요약, 간단한 언어 상호운용(polyglot). 대체로 “정해진 절차를 정확히 밟으면 되는” 작업입니다.
실패한 것들: MIPS용 DOOM 빌드, QEMU 부팅, 정규식으로 체스 구현, 라만 분광 피팅, 메타순환 평가기(scheme)… build/compile, 수치 알고리즘, 에뮬레이션, 정규식 계열에 몰렸습니다.
실패 원인을 뜯어보니 절반 이상이 시간 초과였습니다. 참고로 이 모델을 27B 4bit·8bit와 나란히 비교한 결과는 Qwen3.8 27B — 4bit/8bit/Flash Next 비교에 있습니다.
실패 25건 (밤샘분 기준)
  타임아웃      13
  오답(채점 실패) 9
  실행 오류      3
한 태스크당 제한 시간이 15~60분인데, 모델이 그 안에 못 끝내고 잘린 게 13건입니다. 문제를 파악하면 몇 분 만에 풀고, 못 풀면 계속 헤매다 시간만 태우다 실패합니다. 10분 안에 안 끝나면 대체로 실패라는 게 두 번의 실행에서 반복됐습니다. install-windows-3.11 같은 건 65분을 CPU 100%로 매달렸다가 결국 타임아웃이었습니다.
그런데 진짜 사건은 서버 쪽이었다
밤새 지켜보면서 더 신경 쓰인 건 통과율이 아니라 서버였습니다. mlx-serve가 네 번 멈췄습니다.
증상이 특이합니다. 서버 상태는 ready인데 아무 요청도 처리를 못 합니다. 로그엔 <- 0+0 tokens만 찍히고, RSS가 뚝 떨어지고, CPU는 거의 0. 저는 이걸 wedge라고 부릅니다. 재시작 말고는 답이 없습니다.
네 번 다 공통점이 있었습니다. 5만 토큰 안팎의 큰 요청을 처리한 직후에 났습니다. 특히 schemelike-metacircular-eval 태스크가 유독 큰 트라젝토리를 만들어서, 이 태스크 하나가 뒤쪽 wedge 두 번을 연달아 일으켰습니다.
watchdog가 네 번 다 살렸다
앞선 실행에서 이 wedge를 겪고 나서, 이번엔 감시 스크립트를 하나 붙여뒀습니다. 2분마다 서버에 ping을 보내서 두 번 연속 응답이 없으면 서버를 죽이고 다시 띄우는 겁니다.
# 2분마다 확인, 2회 연속 실패면 재시작
while true; do
  if curl -s --max-time 45 .../v1/chat/completions -d '{...,"max_tokens":4}' | grep -q choices
  then fail=0
  else fail=$((fail+1))
    if [ $fail -ge 2 ]; then
      pkill -9 -f "mlx-serve serve"; sleep 3
      rm -rf ~/.mlx-serve/kv-cache
      nohup mlx-serve serve ... &   # 프로덕션 옵션 그대로
      sleep 60; fail=0
    fi
  fi
  sleep 120
done
밤새 이 watchdog가 네 번 다 무인으로 복구했습니다. 앞선 실행에선 wedge마다 제가 직접 재시작해야 했는데, 이번엔 자다 일어나 보니 네 번 죽었다 살아났고 벤치는 계속 돌고 있었습니다. wedge 사이 최장 무재시작 기록은 4시간 51분이었고요.
한 가지 함정이 있었습니다. watchdog의 재시작 명령에 프로덕션 옵션(--kv-quant 8 같은)을 빠뜨리면, 재시작될 때마다 서버가 튜닝 안 된 상태로 돌아옵니다. 재시작 명령을 실제 기동 옵션과 똑같이 맞춰두는 게 중요했습니다.
ping이 만든 가짜 wedge
로그를 보다가 헷갈린 게 하나 있었습니다. <- 0+0 tokens가 밤새 30번 넘게 찍혔는데, 실제 wedge는 4번뿐이었습니다.
나머지는 watchdog의 ping이 만든 겁니다. 서버가 긴 요청을 처리하는 중이면 ping이 뒤에서 45초를 기다리다 스스로 취소되는데, 그게 0+0 tokens로 남습니다. 진짜 wedge(RSS 붕괴 + 연속 0+0 + 서버 재시작)랑 구별하려면 서버 uptime을 같이 봐야 합니다. uptime이 유지되고 있으면 그 0+0은 그냥 ping 취소입니다.
정리
로컬 4bit 모델로 터미널 에이전트 벤치 절반을 통과한 건, 기대보다 나쁘지 않았습니다. 다만 어려운 태스크에서 시간 안에 못 끝내는 게 통과율의 발목을 잡았고, 이건 모델 실력의 문제라 인프라로 어쩔 수 있는 게 아닙니다.
반대로 인프라 쪽은 이번에 확실히 배웠습니다. mlx-serve가 대형 요청 뒤에 가끔 멈추는 건 여전히 원인을 완전히 잡진 못했지만, 멈추는 걸 못 막아도 자동으로 되살리는 것만으로 밤샘 무인 실행이 가능해졌습니다. 그게 이번 실행의 진짜 수확이었습니다.
(2026-09-02 실측. 통과율은 89개 완주가 아닌 70개 채점 기준이라 경향으로만 보시면 됩니다.)